2019年9月21日土曜日

MinIONの稼働開始

ナノポア社のMinIONが研究室に導入されたが、コントロール用のPCも納入され、いよいよ本格的に稼働するようになった。最初の用途は、研究室で進められているアブラナ科植物の細胞融合個体やコムギ-オオムギ染色体添加系統におけるゲノム構造変異の検出で、ライゲーションベースのプロトコルを用いてDNA-Seqをすることになる。
MinIONは、制御用のコンピュータにそこそこのスペックを要求する。選定を頼まれたので色々考えたが、コマンドライン操作が特段の設定なく容易にできて、アップデート等の保守が楽という考えからMac mini(2018)を選んだ。これまでのMac miniより大幅に能力が上がり(値段も上がり)、シークエンス後の解析にも使いやすくなっていると思う(ただし拡張性はない)。後からメモリもストレージも増やせないので、MinIONに必要な条件より多少積み増して32GbRAMにした。CPUは8th Core i7 3.2GHz、SSDは1TBにした。データが増えてきたら、外付けのSSDで対応しようと思っている。

ナノポアのシークエンサーについてのプロトコルは、機材を購入した上で、登録したコミュニティサイトにアクセスしないと基本的に得られないようになっているようだ。サイトにログインすると色々なプロトコルや最初にやるチュートリアルなどの情報が得られる。概ね見やすく情報が整理されているように感じた。


実験室の片隅を借りて、MinION解析用のベンチを即席で作った。macが奥に鎮座し、その前に実験スペースが作られるというこれまでとちょっと変わったベンチになった。横に、小型の卓上遠心機とVortex、Qubitを置いている。

 電源につないでみると、MinIONの側面の排気口っぽいとこにLEDがついていて解析中はずっと点灯していたのが、なんとなくかっこよかった。


 シークエンスのラン前にgDNAをライゲーションするが、操作自体は簡単だった。ただ、最初のうち慣れないと目安の70分よりかはだいぶん時間がかかった。基本的にプロトコルの通りに手作業していけばよかった。一番問題になるのはDNAの抽出と精製のステップだろう。ナノポアのサイト内にも、植物の場合のDNA抽出方法のプロトコルが一つ置いてあった。基本的にはCTAB法でとって短い断片を取り除く精製を行うという感じのようだ。日本ジーンが取り扱っているShort Read Eliminator XSも購入された。投入DNAの濃度が25-150ng/ulに指定されており、それを下回ると収量が悪いと書いてあるので、抽出の際のElution Buffer量には注意が必要だし、場合によっては濃縮してやらないといけないだろう。前回、同じくロングリードのPacBioシーケンサーでシークエンスした際は、別の研究室のDNAプチVacをお借りして遠心しながらヒートして濃度を調節した(関係ないけれど、この製品はもう販売終了になったらしい。結構便利だと思っていたので残念)。


MinIONは本体は制御用の電子回路っぽい機械で、実際の流路や読み取りのナノポアがあるのは本体にセットするフローセルの方だ。こちらは黒いパックに入っており、使い終わった後の返却用の説明書?っぽいものも同封されていた。


 実際にフローセルをセットしてみたところ。黄色っぽい四角いところにナノポアがあるらしい。反対側にあるくねくねしたところが廃液が流れていくところ。チュートリアルでは、とにかくエアバブルを入れるなと注意していて、空気が流路に入るとナノポアが使えなくなってしまうらしい。なんとなく、キャピラリーシークエンサーでエアバブル抜きをしてい当時のことを思い出してしまった。あの頃もエアバブルを混ぜてしまって失敗するというケースがたまにあった。こちらはフローセルごとダメにしてしまうようで、ちょっと注意が必要。

 操作して行ってる途中で、なんとなく小さな泡が見えるような気がしてとても心配だったが、シークエンス自体はアクティブなポアを見る限りちゃんとできているようだ。使用後にフローセルを洗って保存しておく時にもバッファーをロードしなくてはならないが、ここでも同様にエアバブルを入れないように最初に吸い取る作業をしなければならない(ラン後にここをちょっとまちがえてしまった気がする。このフローセルがどうなってしまっているのか、何かのサンプルで検証してみたいと思う)。

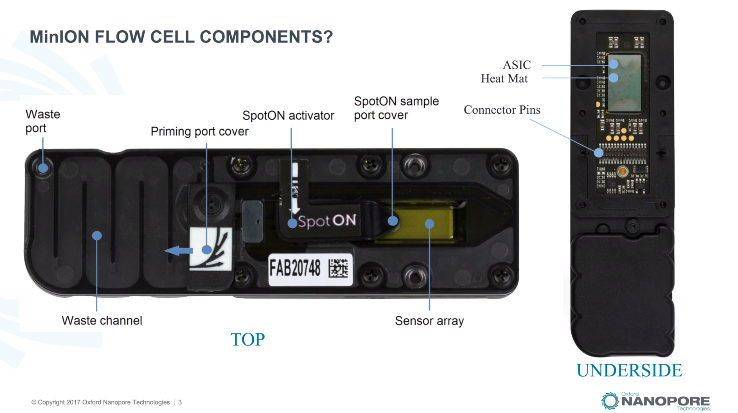
 ネットで見つけたフローセルの解説図。Priming portからエアバブル発生防止のための吸い出しをしなければならない。また、ここには書いていないようなのだが、廃液が流れるところの最初の方のところにもWaste portがあり、ここからでも廃液を捨てることができる。

解析中はCPU使用率はユーザー側のものが跳ね上がっており100%に近い稼働になっていた。一方でメモリプレッシャーにはまだ余裕がある印象だった。とにかくずっとMacminiのファンが唸って熱い排気を出していた。結構頑張って働いてるんだなと思った。シークエンスが終わっても、PC側ではBasecallが続くのでPCは動いたままになる。

最初にチュートリアルとしてLambdaDNAをシークエンスした時に手間取ったのは、クラウドベースの解析ソフトの使用方法だった。PC側のfastq等の出力ファイルをアップロードして解析してくれるEPI2MEというアプリケーションもチュートリアルにしたがって導入していたのだが、初期設定で指定されているディレクトリとデータが吐き出される場所が異なっていたらしく、最初全然アップロードされなかった。Library/MinION下のところにデータが出てくるディレクトリがあったが、そこを直接指定するとエラーになった。少し検索してみると、アクセス権の問題があるようだった。ファイルをホームディレクトリ下に作ったディレクトリにおき、そこを指定すると、解析が始まった。
実際には、fastqファイルまたはfast5ファイルを得たら、後のマッピングやアセンブル等は手元のコンピュータで行うことになりそうなので、あまり使う機会はないかもしれない。

今後植物のgDNAをいろいろ抽出し、精製方法も変えた場合にどのような結果になるか、最初のうちはいろいろと比較しながら、楽に抽出精製して使用に耐えるデータを出せる条件を掴みたいと思う。


2019年8月22日木曜日

Google ColabでJupyterを使ってみる

IT系のブログや記事を見ていると、開発や機械学習でGoogleのColaboratory (Google Colab)というサービスを利用することについて解説してあるのをよく見る。Colaboratoryは、個人が機械学習の教育や研究をするときに使える無償のツールで、Jupyterノートブックの環境として利用できる。googleのアカウントを持っている人だったら、そこから使うことができる。自分はsafariから使ってみたが、chrome, firefox、safariでは検証済みとのことだ。話題になっているのは、機械学習に必要なGPUなどのリソースを無償で使うことができるためのようだ(ただし、連続使用時間は12時間に制限されているらしい。暗号通貨採掘などに使われないようにするためのようだ)。Jupyterは自分で使う場合、pythonの他にRやBashなどのカーネルを利用するようにできるが、Colabではpython2と3のみ提供されている。将来的には他のカーネルを利用することができるようになるかもしれない。

自分のgoogleアカウントに行き、colabを立ち上げてみる。デザインは少し異なるが、Jupyterノートブックのファイルができるので、helloworldしてみる。


使い方はほとんどローカルのJupyterと同じだった。ファイルを保存するとgoogleドライブに.iynb形式でファイルが保存される。ファイルを利用するために、ドライブの設定で、Colabのところにチェックを入れた。


そうすると、利用するアプリとして、google colaboratoryが出てくるようになる。


 Markdownはテキストボックスという名前で利用できる。左側で入力すると、右側に成形された書式で出力される。


実行すると、以下のように出力される。


colabには、よく使われるライブラリがあらかじめ使えるようになっている。numpyをインポートして、行列の演算を行ってみた。


anacondaを導入しても、あらかじめ主要なライブラリを一緒にインストールすることができるが、colabは自分のパソコンで何もしなくてもだいたい必要なものが利用できるようになっているのは便利だと思った。さらに、機械学習などで利用されると思われるコードがあらかじめスニペットとして用意されているようだ。左側のメニューでコードスニペットを選んで、簡単にスニペットのセルをコピーすることができる。


実際に実行してみたところ。これは手間いらずだ。


googleドライブにアップロードしたファイルを参照するときは、ドライブをマウントする必要がある。やり方は簡単で、左側からドライブにマウントのボタンをクリックすると、必要なコードがコピーされ、それを実行すると以下のようになる。リンクをクリックして自分のドライブがあるアカウントにログインすると、キーが表示されるので、コピーして入力する。

以上の作業を行うと、/content/drive/My\ Drive/の下にgoogleドライブがマウントされる。一度colabのノートブックを閉じて再度開いたときもマウントされたので、一定期間はマウントされるのかもしれない。せっかくなので、ランダムドリフトの簡単なシミュレーションをして結果をプロットするスクリプトをアップロードして、colabで実行してみた。

見えているファイルplot.pyを実行する。pythonファイルを実行するときは、%run file.pyでいけるようだ。初期頻度や世代数、集団サイズ、試行回数を入力すると、以下のように結果がプロットされる。図では、初期頻度が0.5で、30世代100個体の集団を4回シミュレーションしている。


すごいサービスだと思った。何も設定しなくても、googleアカウントがあればすぐにJupyterノートブックを使うことができるし、機械学習などの勉強に必要なリソースが無償で利用できるのだから、使ってみる価値があると思った。大学の研究室でpythonを導入したり、学習したりする場合にも、環境の準備をほとんどすることなくいきなり始めることができるわけなので、導入の敷居はとても低くなる。とりあえず、研究室の研究なり学習でよく使うスクリプトなどをライブラリとしてアップロードした上で使えば、使用PCの条件なども問題にすることなく一斉に演習ができるというのは、かなり便利なのではないかと思う。


2019年8月18日日曜日

Dockerの導入

夏季休業の期間を利用して、以前から使いたかったDockerを導入してみた。Dockerは、Docker社が開発しているプラットフォームで、アプリケーションの単位の仮想環境を作成したり、それを配布したりすることができる(らしい)。技術的な詳細は自分には難しいのだが、いろいろな解説を見ると、普通の仮想化デスクトップが、ゲストのOSを丸ごとホストのOSの上で動かしているのに対し、コンテナ技術では、アプリケーションの単位で仮想環境が作られているらしい。説明の図には、ホストOSの上にDockerのエンジンが乗り、その上にOSではなくbinaries/librariesが乗っている図があり、(情報系の人のような正確な理解じゃないけれど)なんとなく直感的には理解できる。


バイオインフォマティクスの分野でも、BioContainersで解析プログラムがインストールできるようになっており、以前から興味を持っていた。これができれば、十年前に依存環境の問題で何十時間も費やしていた(そして結果的にビルドに失敗した!)時のような地獄から解放されるかもしれない。また、今はそこまでではないが、将来的には論文の投稿時に、解析環境を丸ごと開示するのがデフォルトになるかもしれない。なったら、多分大変だろうが、生物系の研究の再現性を担保するためには、必要な道かもしれないと最近思う(でも、純粋なバイオインフォマティクス系でない研究室にとっては、やはり重荷になると思う、最初は)。

今回は、メインに使っているMacBook Proの環境(i7、16GbRAM)の環境にdocker desktopを導入した。


1TbのSSDを積んでいるが、色々とデータが増えてそこまで余裕はない。もしdockerでアプリケーションをたくさん導入するのであれば、解析の都度使うものをpullしたり、解析が終わったものを環境ごと保存しておくために大きなディスクを持っていた方がいいのかもしれない。この辺りの感覚は、これから使っていきながら掴んでいきたい。

dockerの概要は、webの解説に載っていた。

設定としては、最初なので勝手がわからないが、とりあえずCPUs4、メモリは8Gb、Swapは1Gbとした。負荷の大きい解析には、もう少しメモリ使用量をあげたほうがいいかもしれない(そもそも、linuxのサーバーマシンの方に導入してもっとリソースが割けるようにしたほうがいいだろう。今使っているものは、xeon、96GbRAM)。


手始めに、Parliament2というマッピングの結果からゲノムの構造変異を検出するためのコーラーを導入してみた。導入は非常に簡単で、コマンド一つ(docker pull dnanexus/parliament2 )でプルすることができる。parliament2の説明を見ると、幾つもの異なるコーラーを使い、その結果を統合してくれるようだ。多分、10年前の自分であれば、これらを個別に導入するという段階で、かなり腰が引けていたと思う(そして、相次ぐbuild失敗に際限なく時間が過ぎていき、結果が出ずに、というかそもそも解析が始められずに泣きそうになっていたんじゃないかと思う、技術の進歩すごい)。これから実際の解析に使っていきたい。

試しにいくつかのプログラムがbiocontainersで利用可能になっているか確かめてみた。メジャーなもので対応しているものも多いが、登録されていないものも見つかった。そもそも導入が簡単なものは、dockerを使わないほうが余計なリソースを割かずにすみ良いのだろう。この辺りの見極めをして、良い運用方法を決めていきたい。